
Strumenti Utente
Barra laterale
crescita_degli_hapax_in_cesare
Questa è una vecchia versione del documento!
La crescita degli hapax in Cesare
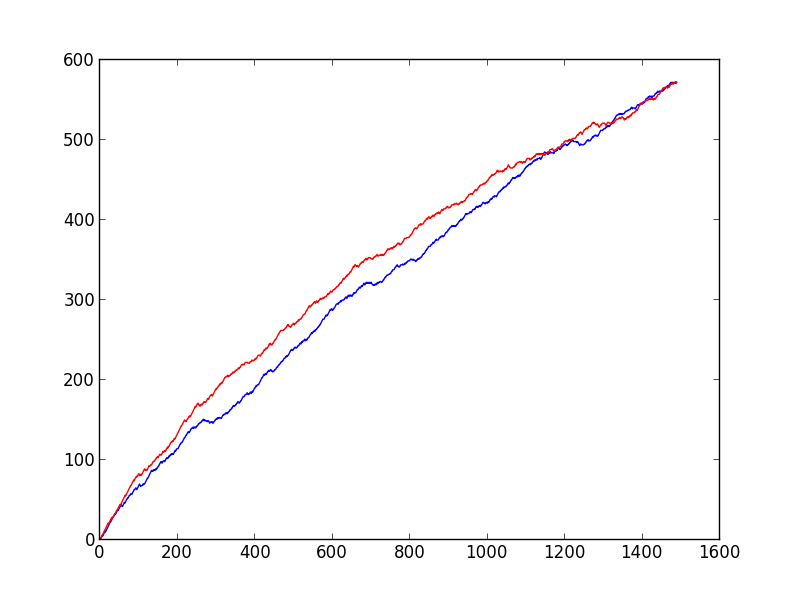
Le istruzioni seguenti creano il grafico (in blu) della crescita degli hapax in un brano di 1488 parole tratto dal De bello Gallico di Gaio Giulio Cesare. In rosso è il grafico della crescita degli hapax creato a partire dallo stesso testo, ma dopo aver randomizzato l'ordine delle parole (tranne che per l'ultima porzione, la linea in rosso dovrebbe mostrare generalmente valori superiori a quelli della linea in blu).
- 1
import matplotlib.pyplot as plt
import xml.etree.ElementTree as ET
from random import shuffle
xmlfile=ET.parse('Testi/ldt-1.5.xml')
root=xmlfile.getroot()
dati=root.findall('.//sentence[@document_id="Perseus:text:1999.02.0002"]//word')
testo1=[i.attrib['form'].lower() for i in dati]
testo2=testo1[:]
shuffle(testo2)
def cr_hap(testo):
    hapax=[1]
    for i in range(1,len(testo)):
        n=testo[:i].count(testo[i])
        if n == 0:
            hapax.append(hapax[-1]+1)
        elif n == 1:
            hapax.append(hapax[-1]-1)
        else:
            hapax.append(hapax[-1])
    return hapax
hapax1=cr_hap(testo1)
hapax2=cr_hap(testo2)
plt.plot(range(1,len(testo1)+1),hapax1,'b-')
plt.plot(range(1,len(testo2)+1),hapax2,'r-')
plt.show()
Dovrebbe prodursi un grafico simile a questo (ma si noti che l'andamento della linea rossa sarà necessariamente diverso in quanto la randomizzazione dell'ordine delle parole produrrà ogni volta un risultato differente):
crescita_degli_hapax_in_cesare.1621495277.txt.gz · Ultima modifica: 2021/05/20 07:21 da 127.0.0.1
Strumenti Pagina
Ad eccezione da dove è diversamente indicato, il contenuto di questo wiki è soggetto alla seguente licenza: CC Attribution-Share Alike 4.0 International


