
Strumenti Utente
Barra laterale
frequenza_relativa_dei_casi_grammaticali_latini
Questa è una vecchia versione del documento!
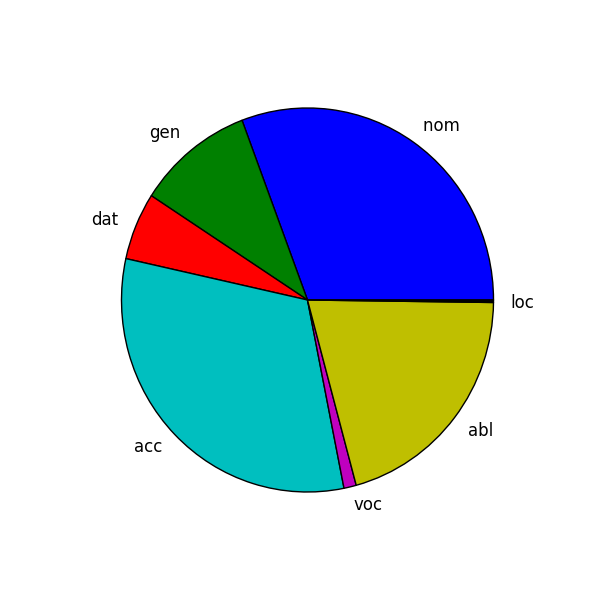
Frequenza relativa dei casi grammaticali del latino
Si noti che il caso vocativo è necessariamente sottostimato rispetto all'uso quotidiano data la tipologia testuale del corpus.
from __future__ import division
import re
import matplotlib.pyplot as plt
file = open('Testi/ldt-1.5.xml', 'r')
dati = file.read()
dati= re.findall(r'word id=\"[^\"]*\" form=\"([^\"]*)\" lemma=\"([^\"]*)\" postag=\"(.)(.)(.)(.)(.)(.)(.)(.)(.)', dati)
fless_caso = [o for o in dati if o[2] in ['n', 'p', 'a', 't'] and o[9] in ['n','g','d','a','v','b','l']]
n=len(fless_caso)
nom=len([o for o in fless_caso if o[9]=='n'])/n
gen=len([o for o in fless_caso if o[9]=='g'])/n
dat=len([o for o in fless_caso if o[9]=='d'])/n
acc=len([o for o in fless_caso if o[9]=='a'])/n
voc=len([o for o in fless_caso if o[9]=='v'])/n
abl=len([o for o in fless_caso if o[9]=='b'])/n
loc=len([o for o in fless_caso if o[9]=='l'])/n
print 'freq. rel. nominativo:', nom
print 'freq. rel. genitivo:', gen
print 'freq. rel. dativo:', dat
print 'freq. rel. accusativo:', acc
print 'freq. rel. vocativo:', voc
print 'freq. rel. ablativo:', abl
print 'freq. rel. locativo:', loc
fig=plt.figure(figsize=(6,6))
ax=fig.add_subplot(1,1,1)
ax.pie([nom, gen, dat, acc, voc, abl, loc],labels=['nom ', 'gen', 'dat', 'acc', 'voc', 'abl', 'loc'])
plt.show()
frequenza_relativa_dei_casi_grammaticali_latini.1621495277.txt.gz · Ultima modifica: 2021/05/20 07:21 da 127.0.0.1
Strumenti Pagina
Ad eccezione da dove è diversamente indicato, il contenuto di questo wiki è soggetto alla seguente licenza: CC Attribution-Share Alike 4.0 International


